
CO₂-Emissionsdatenbank für das Bauingenieurwesen
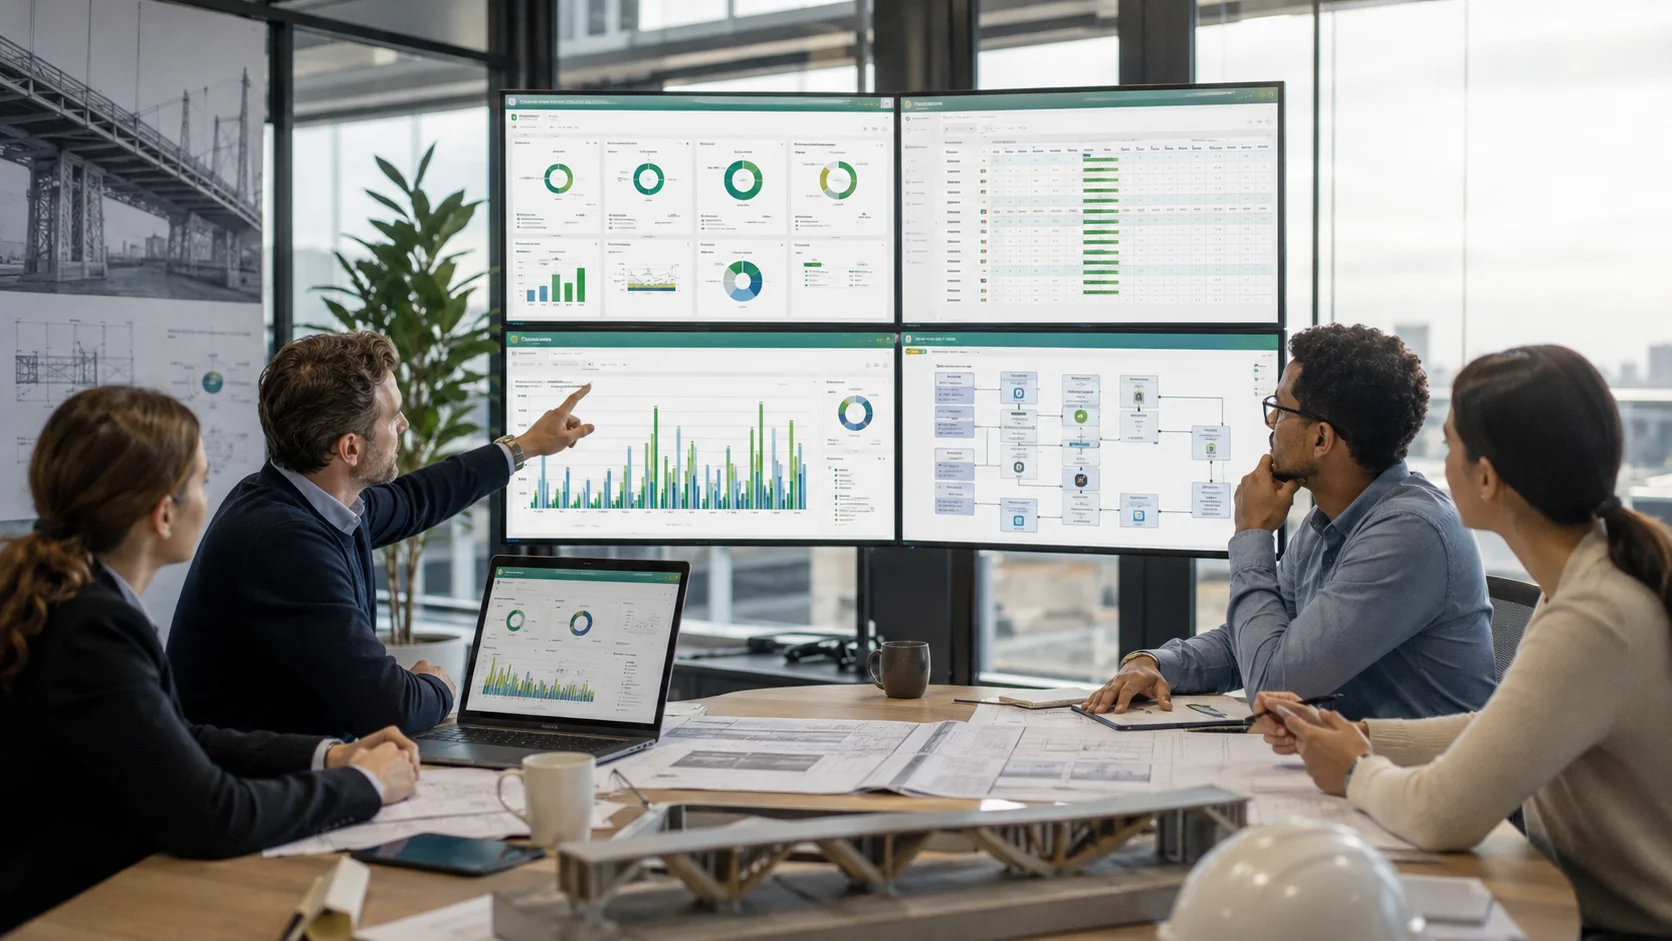
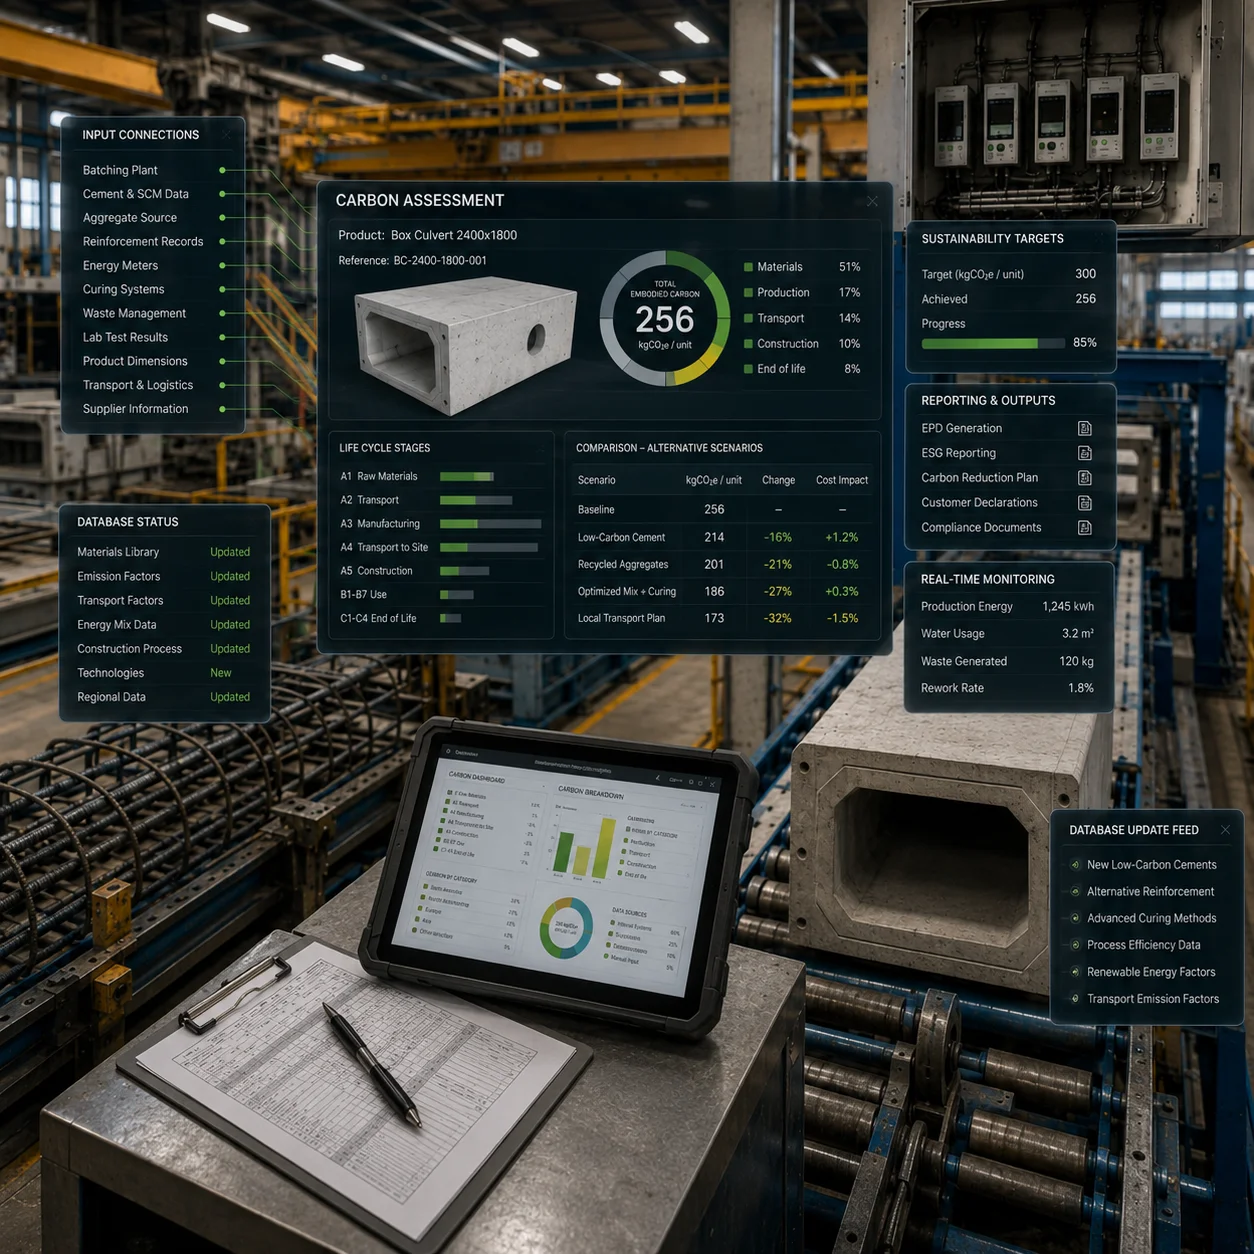
Greifen Sie auf eine umfassende CO2-Emissionsdatenbank zu, die speziell für die Bauingenieurbranche entwickelt wurde. NEXATEK bietet eine umfangreiche, kontinuierlich gepflegte Datenbank, die Baumaterialien, Bauaktivitäten, Ausrüstung, Transport und Energieverbrauch abdeckt, um eine genaue CO2-Bewertung und Nachhaltigkeitsberichterstattung zu unterstützen.
Umfassende Emissionsdatenbank
Datenqualität & Standardisierung
Integration & Ingenieuranwendungen
Nachhaltigkeit & Entscheidungsunterstützung
Häufig gestellte Fragen
Die Verfolgung von CO2-Emissionen ist der Prozess der Schätzung und Analyse des CO2-Fußabdrucks, der über den gesamten Lebenszyklus eines Bauvorhabens entsteht...
Die Verfolgung von Emissionen gibt Ihnen ein klares Verständnis über Ihre Umweltauswirkungen...
Wir verwenden branchenweit anerkannte Methoden...
Geringere Emissionen führen zu niedrigeren Energiekosten, verbesserter Effizienz...
Die CO2-Emissionsverfolgung ist über alle Sektoren hinweg wertvoll...
Ähnliche Projekte
Entdecken Sie weitere innovative Projekte:


Großartige
Lösungen
beginnen mit einem GesprächGroßartige Lösungen beginnen mit einem Gespräch
Möchten Sie herausfinden, wie unsere Dienstleistungen Ihr Unternehmen voranbringen können?
Datenbankbasiertes CO2-Emissionsmanagement im Infrastruktur- und Ingenieurbau
Ein einziger Viadukt-Entwurf kann über 300 Materialpositionen umfassen, deren CO2-Kennwerte häufig als PDF-Dateien vorliegen. Das manuelle Erfassen und Abtippen dieser Dokumente bindet wertvolle Ingenieurstunden und führt zu Übertragungsfehlern, die oft erst Monate später bei einer Rechnungs- oder Ökobilanzprüfung auffallen. Ein digitales Datenbankmanagement für graue Emissionen (Embodied Carbon) ersetzt diese fehleranfällige Aggregation durch ein zentrales, strukturiertes Repositorium verifizierter CO2-Faktoren, das direkt an BIM- und Ökobilanzierungs-Workflows (LCA) angebunden ist. NEXATEK baut derartige Dateninfrastrukturen für Infrastrukturorganisationen auf – in der Regel als Baustein umfassender Programme zur digitalen Transformation im Bauingenieurwesen.
Das Datenformat ist entscheidend: Ein als maschinenlesbarer Datensatz hinterlegter Emissionsfaktor lässt sich abfragen, validieren, versionieren und über eine gemeinsame Datenumgebung (Common Data Environment, CDE) teilen. Dieselbe Kennzahl in einem gescannten PDF-Dokument bleibt hingegen eine isolierte Information.
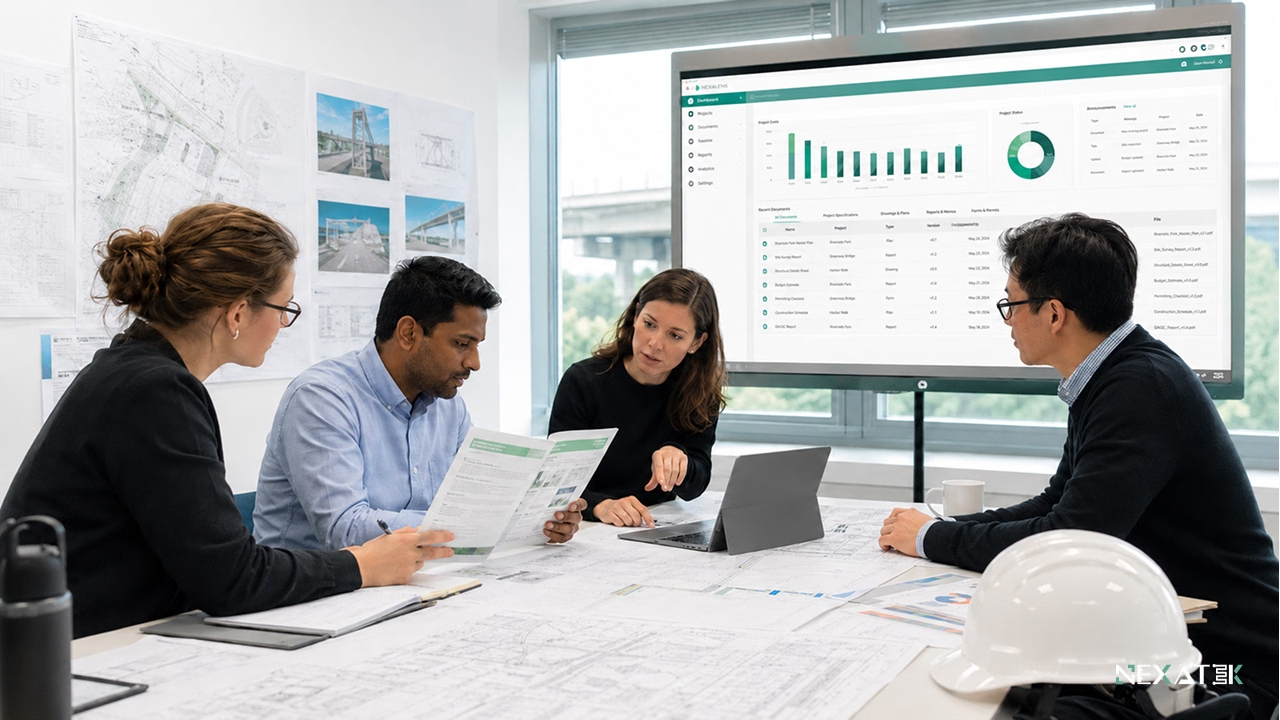 Ein strukturiertes Repositorium überführt verstreute PDF-Werte in maschinenlesbare Datensätze zur teamweiten Validierung und Wiederverwendung.
Die Architektur eines zentralen Repositoriums für CO2-Daten
Eine Tabellenkalkulation speichert einen Emissionsfaktor als einzelne Zahl in einer isolierten Zelle. Ein professionell verwaltetes Repositorium speichert ihn als strukturierten Datensatz mit klar definierten Attributen. Dazu gehören die deklarierte Einheit, das Treibhauspotenzial (Global Warming Potential, GWP) in Kilogramm CO2-Äquivalent (kgCO2e), die abgedeckten Lebenszyklusmodule, der geografische Geltungsbereich sowie die Gültigkeitsdauer. Provenienzfelder belegen den Ursprung jedes Werts – beispielsweise eine Umweltproduktdeklaration (EPD), die nach ISO 14025 und EN 15804 verifiziert wurde.
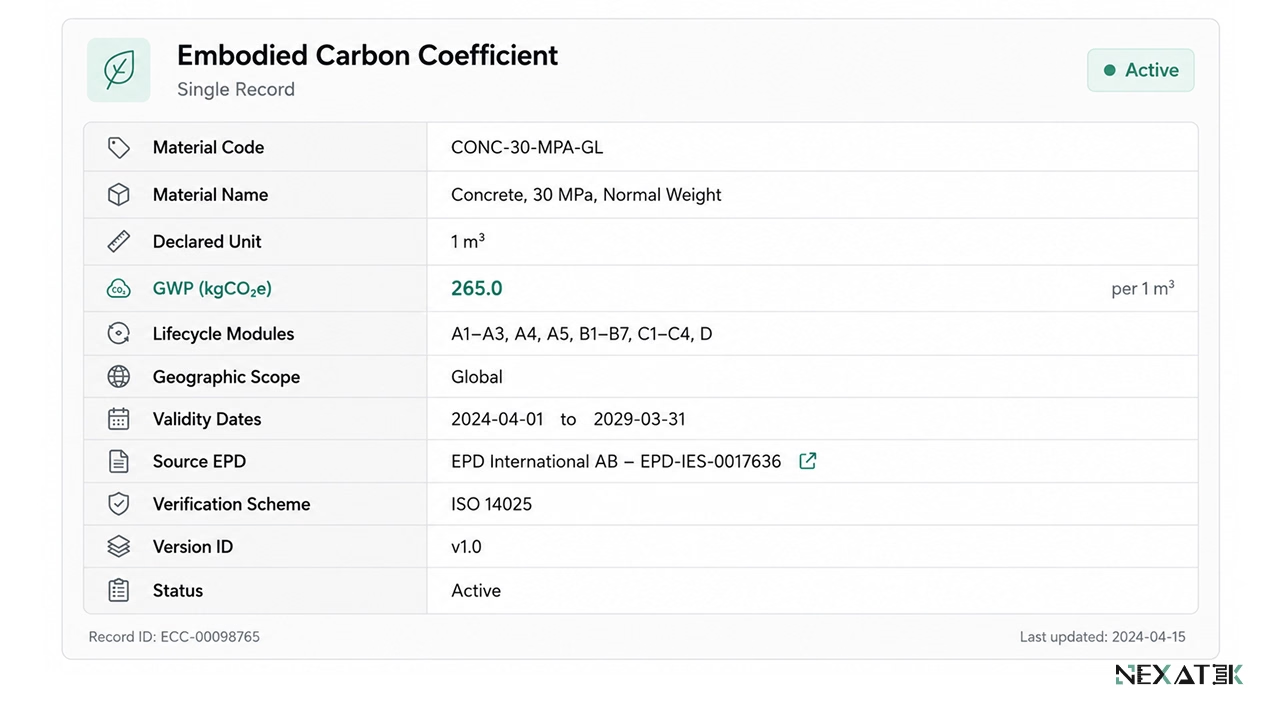 Jeder Faktor benötigt einen lückenlosen Kontext, um projektübergreifend geprüft, versioniert und auditiert werden zu können.
Diese Architektur behebt das Problem fragmentierter Datengrundlagen: EPDs weisen uneinheitliche PDF-Layouts auf, nationale Datenbanken nutzen eigene Formate und lokale Tabellenkopien weichen innerhalb weniger Monate voneinander ab.
Die Versionsverwaltung ist eine weitere fundamentale Anforderung: EPDs verfallen regulär nach fünf Jahren, und Strommix-Emissionsfaktoren verändern sich mit dem Ausbau erneuerbarer Energien. Historisierte Werte behalten ihre definierte Gültigkeitsspanne im System, sodass eine im Jahr 2024 durchgeführte Bilanzierung auch 2027 exakt reproduzierbar bleibt.
Generische Referenzdatenbanken erhalten einen festen Platz im Gesamtsystem: Datenbanken wie das Inventory of Carbon and Energy (ICE) schließen Informationslücken, falls keine herstellerspezifische Deklaration vorliegt. Eine klare Priorisierungslogik gewährleistet einheitliche Abfragen: produktspezifische EPD vor Branchendurchschnitt, Branchendurchschnitt vor generischem Datensatz.
Graue Emissionen und betriebliche Emissionen bleiben von Beginn an trennbar: Modultags unterscheiden zwischen Herstellung (A1-A3), Errichtung (A4-A5), Nutzung (B1-B7) und Entsorgung (C1-C4). Dies ermöglicht die konsistente Auswertung ganzheitlicher Lebenszyklusanalysen (Whole Life Carbon, WLC) aus einer einzigen Datenquelle.
Standardisierung von EPD-Daten für die BIM-Interoperabilität (IFC & COBie)
Klimadaten entfalten ihren vollen Nutzen, wenn sie direkt mit digitalen Modellobjekten verknüpft sind. Durch das Mapping jedes Datensatzes auf IFC-Klassen ordnet eine BIM-integrierte Datenbank einem Bohrpfahl oder einer Asphaltschicht automatisiert den passenden Faktor zu, ohne dass manuelle Recherchen erforderlich sind. Die Bauteilbenennung folgt demselben Standard: Ein Eintrag für Transportbeton führt neben der Handelsbezeichnung auch die IFC-Materialspezifikation. Anfragen aus unterschiedlichen Autorensystemen greifen somit auf denselben Datensatz zu.
Die Harmonisierung von Maßeinheiten ist eine wiederkehrende Hürde: Ein CAD-Modell übergibt Beton in Kubikmetern, während die EPD des Lieferanten auf Tonnen abstellt. Häufig schließt eine implizite Dichteannahme diese Lücke unbemerkt. Ein durchdachtes EPD-Managementsystem macht diese Umrechnung transparent, indem es den projektierten Dichtefaktor zusammen mit seiner Quelle direkt am Emissionsfaktor hinterlegt.
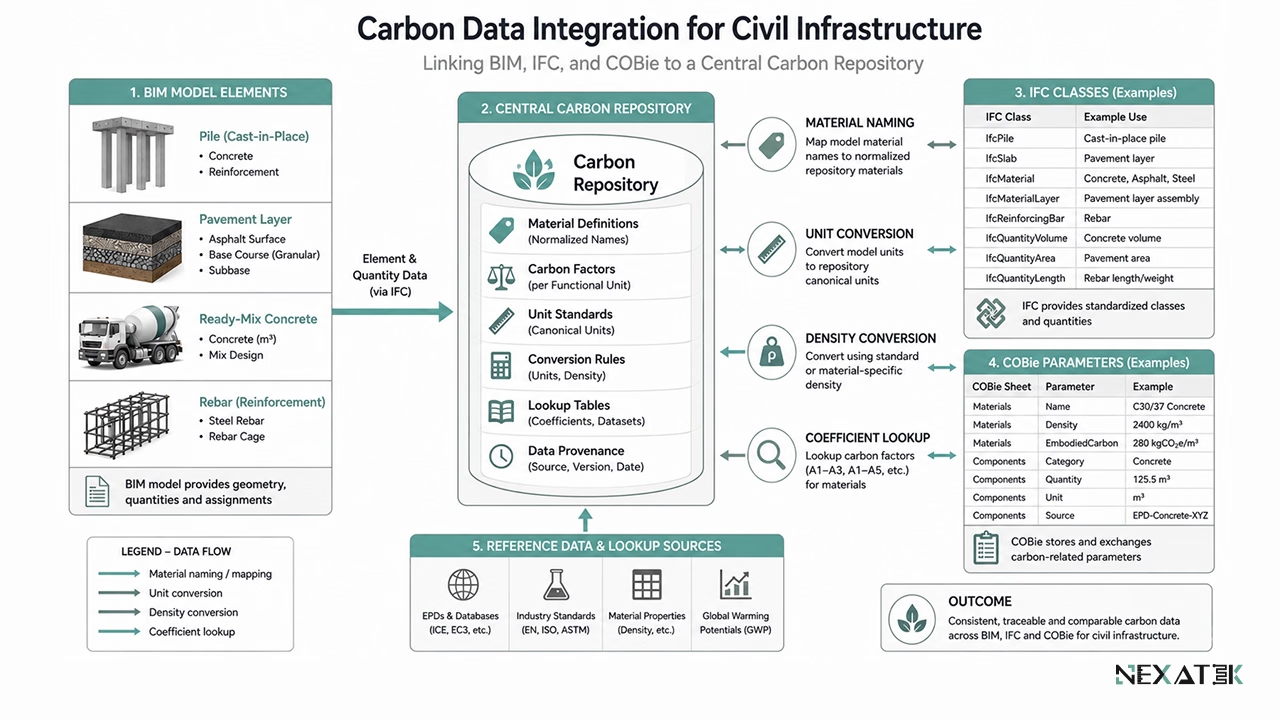 BIM-Interoperabilität basiert auf konsistenter Materialnomenklatur, eindeutigen Einheitenumrechnungen und standardisierten CO2-Parametern.
COBie-Parameter führen dieses Prinzip bis in die Übergabe und Betriebsphase fort: Die CO2-Referenzen verbleiben im Anlagenregister, sodass der Betreiber Faktoren übernimmt, die exakt an die Bauteile gekoppelt sind, die seine Instandhaltungsteams ohnehin verwalten.
Integration von CO2-Datenbanken in den Anlagenlebenszyklus
Die Anforderungen an Emissionsdaten wandeln sich entlang der Projektphasen. Entwurfsteams benötigen Richt- und Benchmarkwerte für Variantenstudien, die Bauleitung erfordert eine reale As-Built-Erfassung, und Asset-Manager müssen Emissionen aus Instandhaltungsmaßnahmen den entsprechenden Nutzungsmodulen zuweisen. Ein zentrales Repositorium deckt diese Phasen ab, wenn die Daten mit Lebenszyklus-Tags versehen sind.
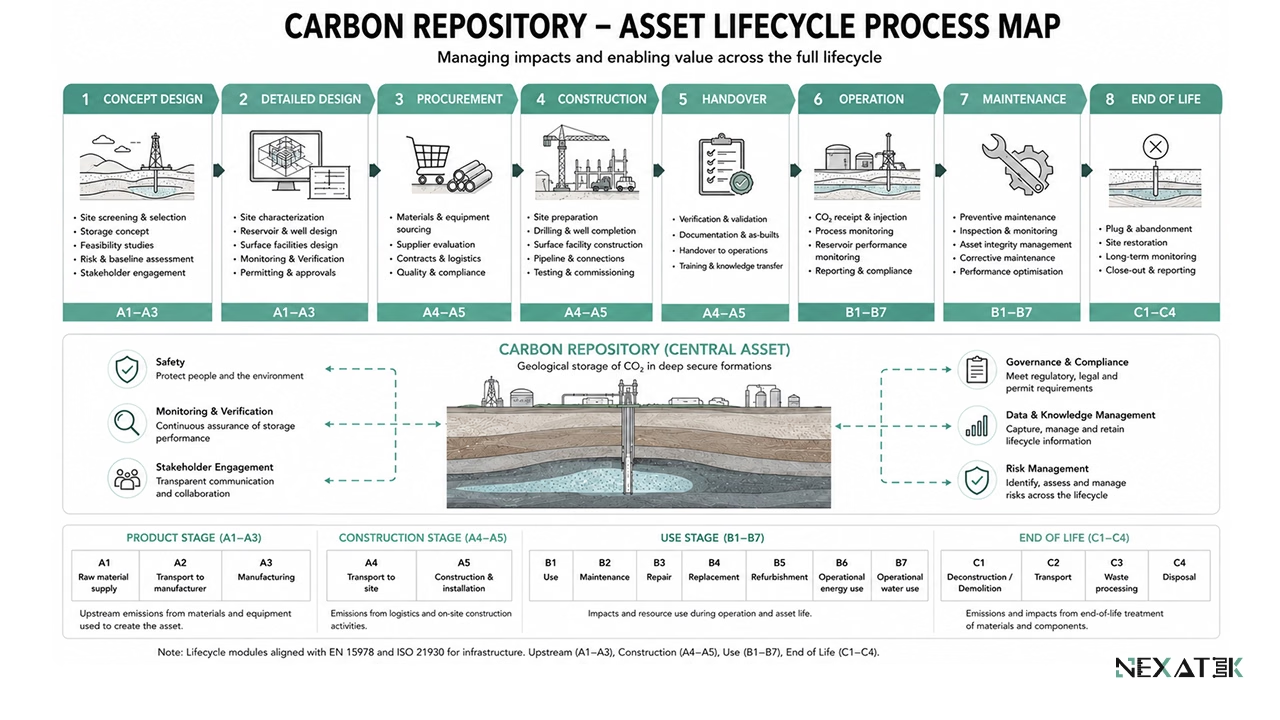 Dasselbe Repositorium unterstützt Vorentwurf, Bauausführung, Übergabe, Betrieb, Instandhaltung und den Rückbau.
Nutzungsphasen-Datensätze (B1-B7) halten die Datenbasis über Jahrzehnte hinweg aktuell: Ein Lagertausch oder ein Fahrbahndeckenerneuerungszyklus greift auf aktuelle Materialfaktoren desselben Systems zurück. Die anfallenden Emissionen werden sauber in den Modulen B2 bis B5 verbucht, ohne die ursprünglichen Errichtungsemissionen zu verzerren.
Variantenvergleich in frühen Planungsphasen und Materialwahl (A1-A3)
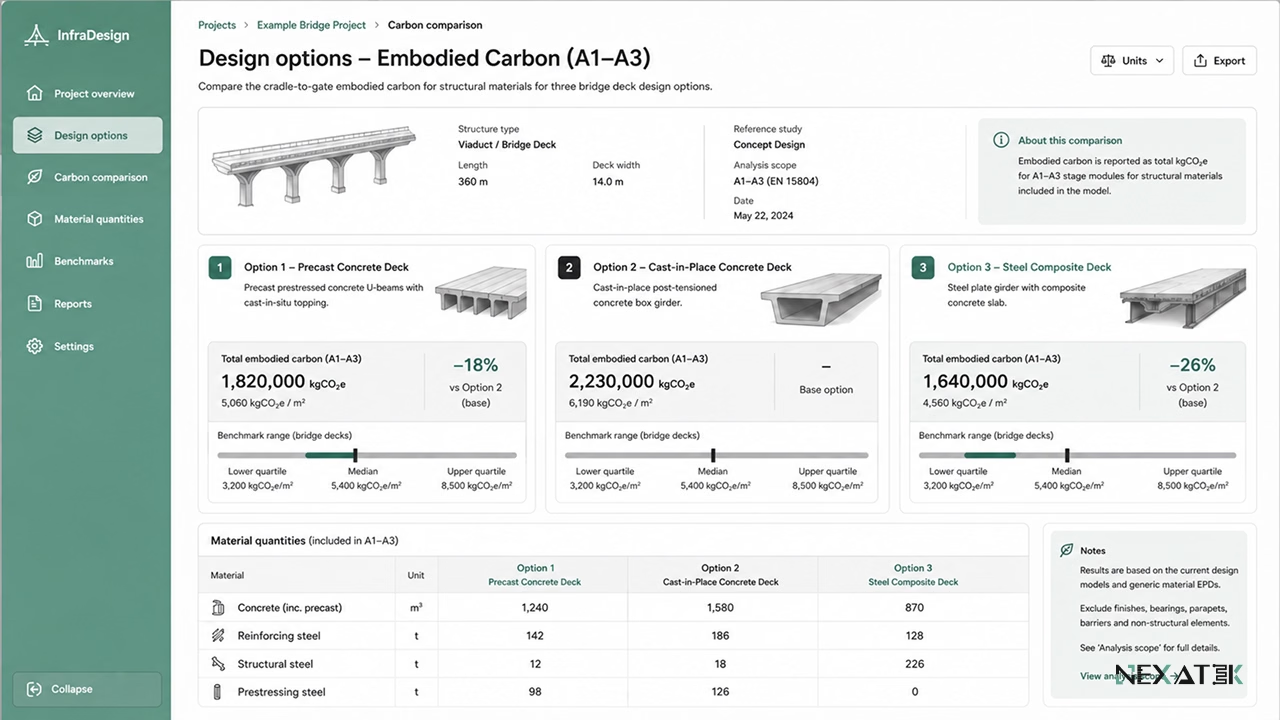
Die produktionsbedingten Emissionen (Module A1-A3) werden weitgehend mit der Materialspezifikation festgelegt. Ein früher Variantenvergleich (Optioneering) besitzt daher das höchste Einsparpotenzial. Eine Software für echtzeitbasiertes CO2-Optioneering fragt die Datenbank direkt anhand der Entwurfsmengen ab. So liefert ein Brückenüberbau-Entwurf seinen CO2-Kennwert unmittelbar während der Planungssitzung und nicht erst im nachgelagerten Berichtszyklus. Der zeitliche Verzug zwischen Entwurfsänderung und ökologischer Neubewertung schrumpft von Wochen auf wenige Sekunden.
Ein Rechenbeispiel verdeutlicht den Hebel: Der Ersatz eines Standardbetons (CEM I) durch eine Mischung mit 50 % Hüttensand (g gemahlenem Hüttensandmehl) kann den A1-A3-Wert pro Kubikmeter um rund ein Drittel senken. Die Datenbank beziffert diesen Unterschied unmittelbar in Tonnen CO2e, skaliert über die Gesamtkubatur der Modellvarianten.
Vergleichswerte stammen aus derselben Quelle: Mittlere CO2-Intensitäten nach Bauteiltypen, abgeleitet aus historischen Projektdaten des Repositoriums, geben Tragwerksplanern konkrete Kennwerte an die Hand.
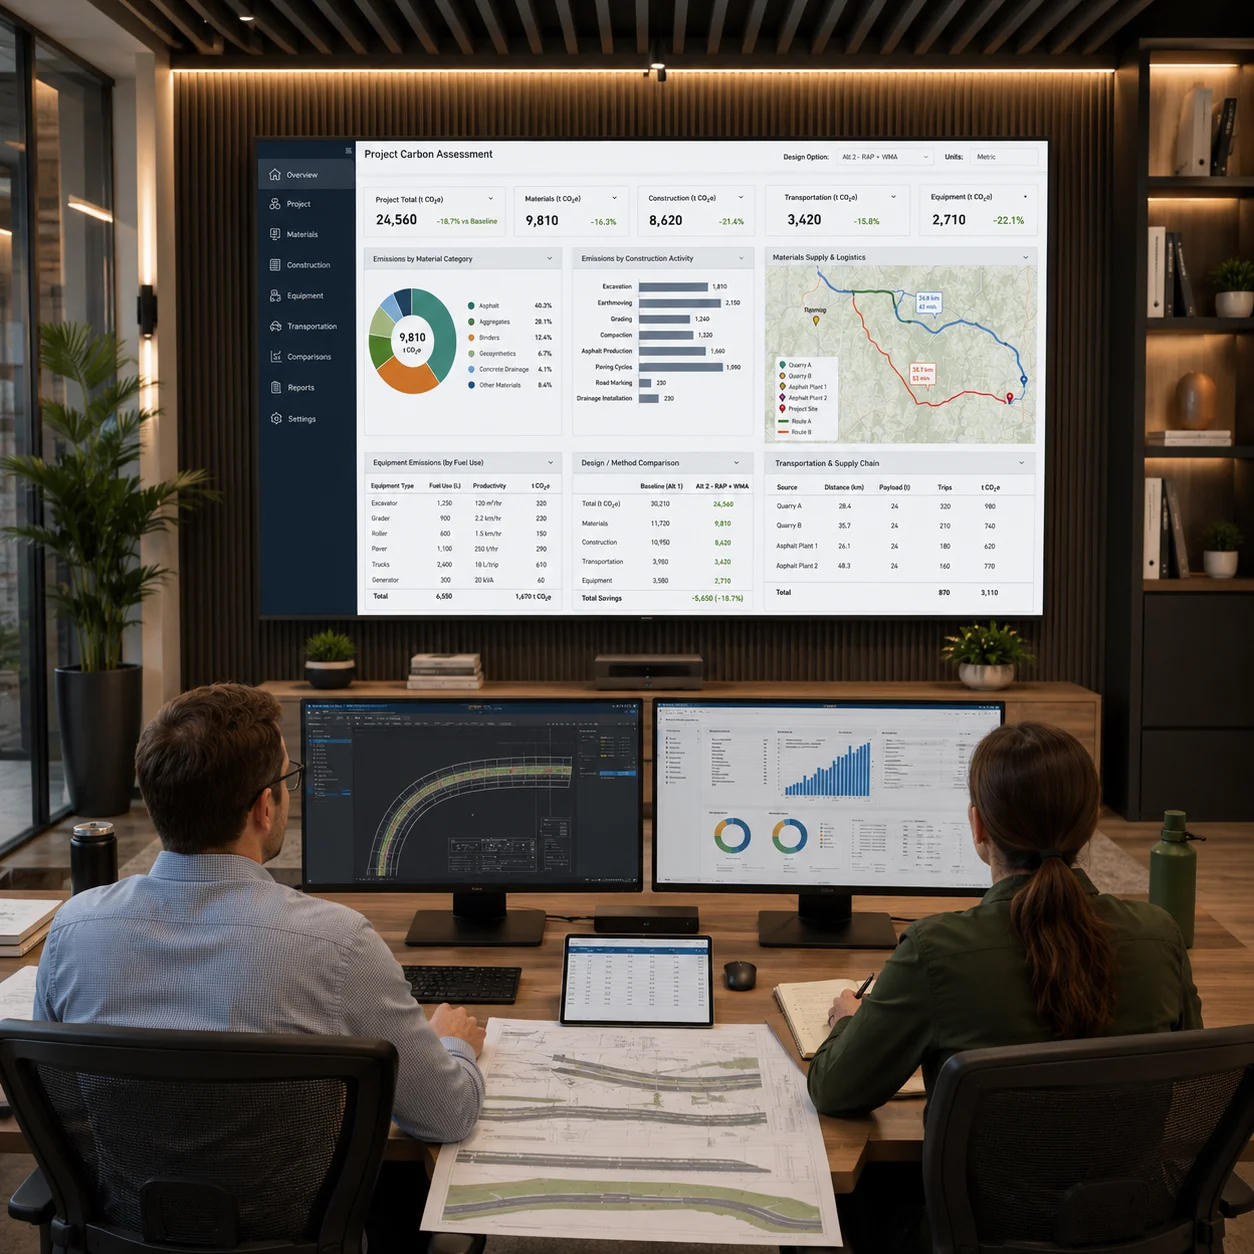
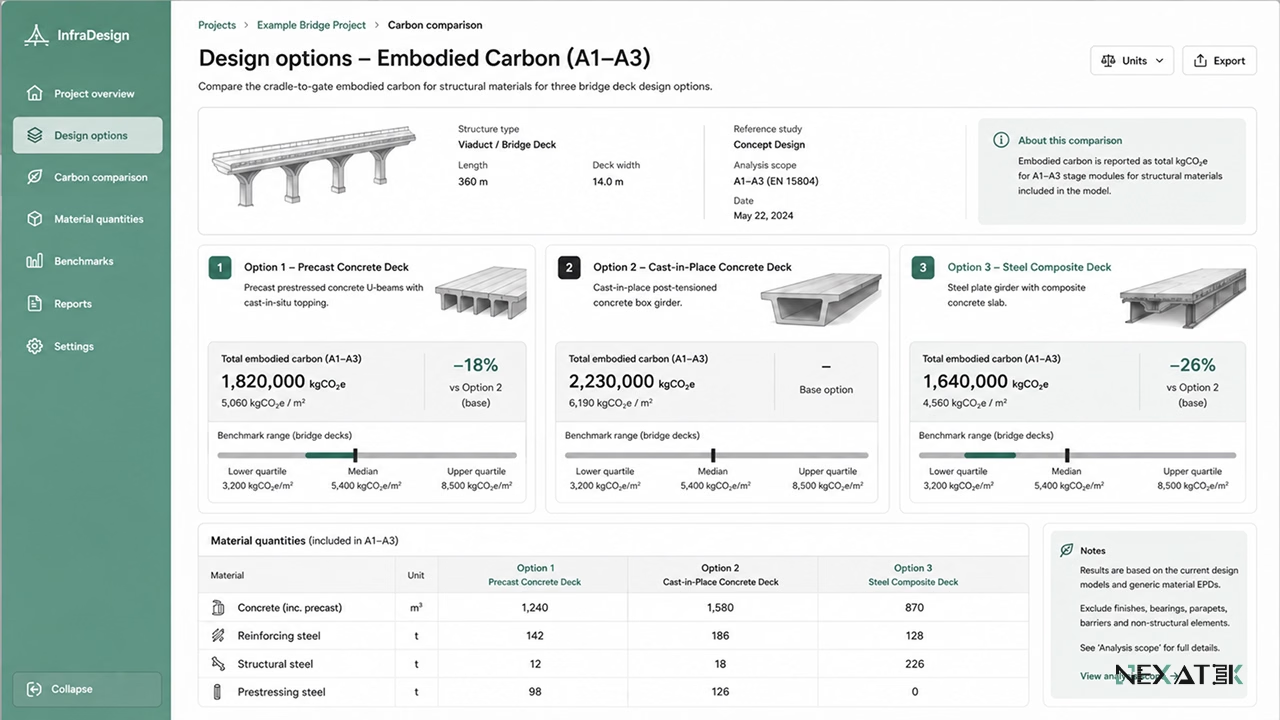 Dashboard-Ansichten unterstützen Ingenieure beim Variantenvergleich gegen CO2-Benchmarks in frühen, flexiblen Planungsphasen.
Erfassung der Emissionen während der Bauausführung (A4-A5)
In den Modulen Transport (A4) und Baustellenmontage/-betrieb (A5) weichen Annahmen realen Messwerten, sobald die Bauarbeiten beginnen. Lieferscheine belegen tatsächliche Transportdistanzen, Betriebstagebücher erfassen Maschinenverbräuche. Beide fließen als As-Built-Datensätze in die Datenbank ein und ergänzen die Schätzungen der Ausschreibungsphase. Das CO2-Tracking in der Bauausführung quantifiziert die Abweichungen: Eine tatsächliche Anfahrt von 95 km gegenüber einer kalkulierten Distanz von 40 km erscheint als präzise Differenz.
Die Baustellenverfolgung verknüpft reale Nachweise mit A4-A5-Datensätzen, um Planungsannahmen mit Realdaten abzugleichen.
Die As-Built-Erfassung sichert zudem die langfristige Datenqualität des Bauwerks: Die bei der Bauabnahme festgeschriebenen Faktoren beschreiben das Bauwerk exakt wie ausgeführt. Jede spätere Instandhaltungsplanung oder Rückbaubewertung (C1-C4) baut auf diesem Datensatz auf.
Technische Spezifikation für Datenbanksynchronisation und APIs
IT-Abteilungen bewerten ein CO2-Repositorium primär nach seinen Integrations- und Schnittstellenfähigkeiten. Eine REST-API bindet die Datenbank an externe Systeme an: Eine Anfrage mit Materialcode und Menge liefert den zugeordneten Faktor, den berechneten kgCO2e-Wert sowie die Provenienzdaten als strukturiertes JSON zurück. Batch-Endpunkte verarbeiten ein vollständiges Leistungsverzeichnis in einem einzigen Aufruf.
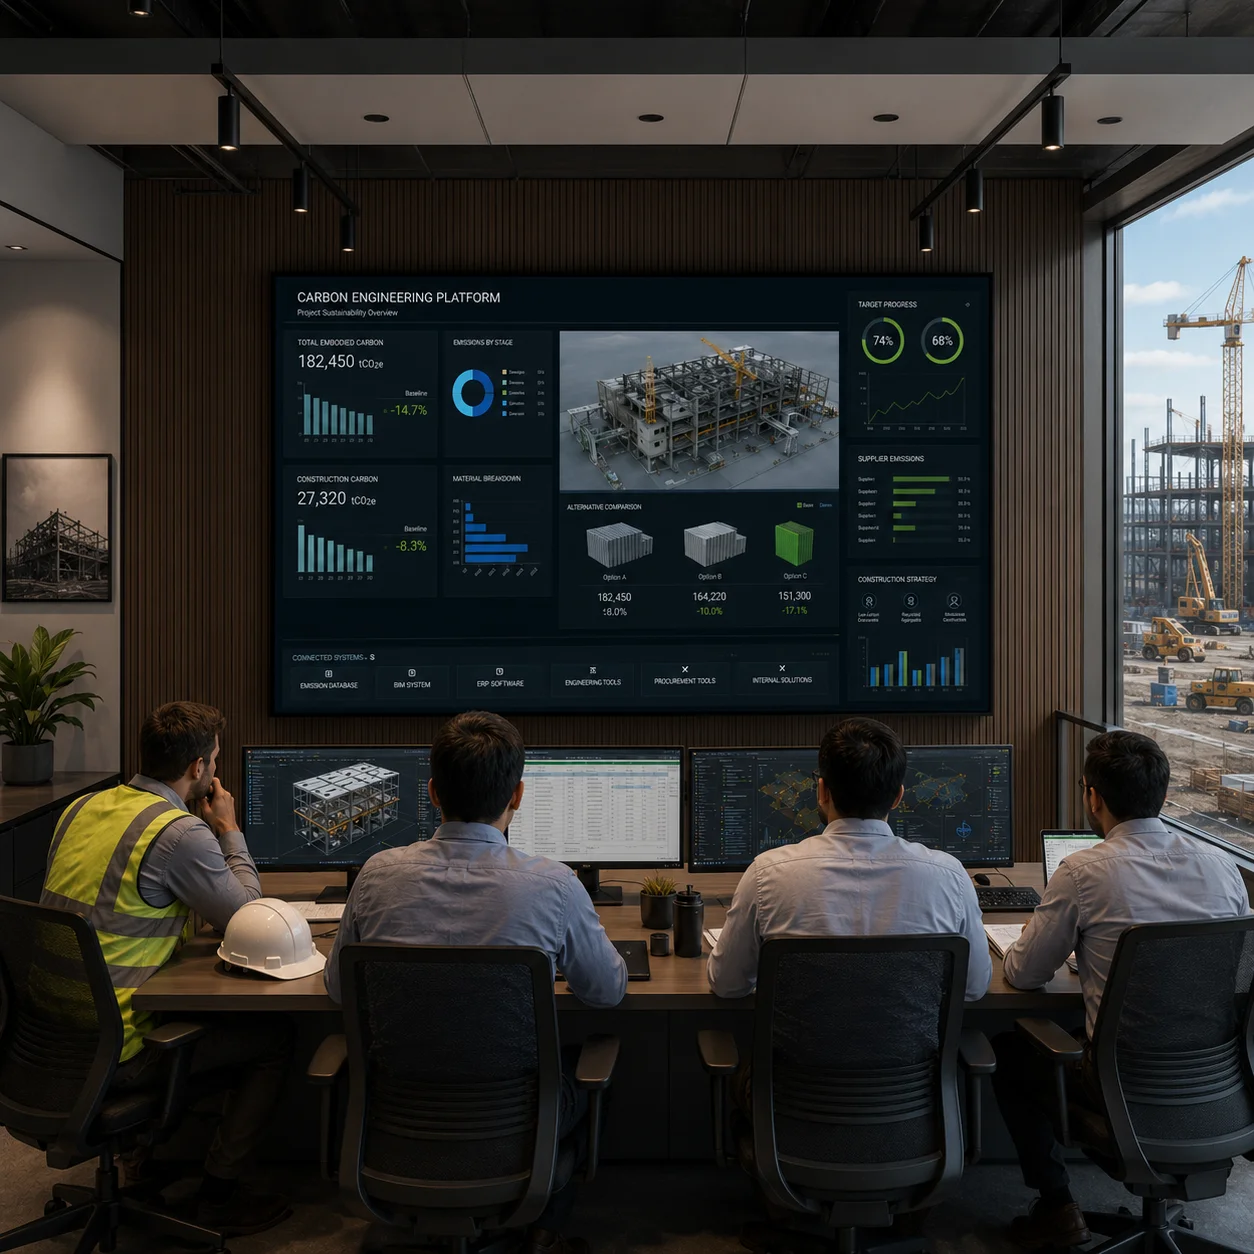
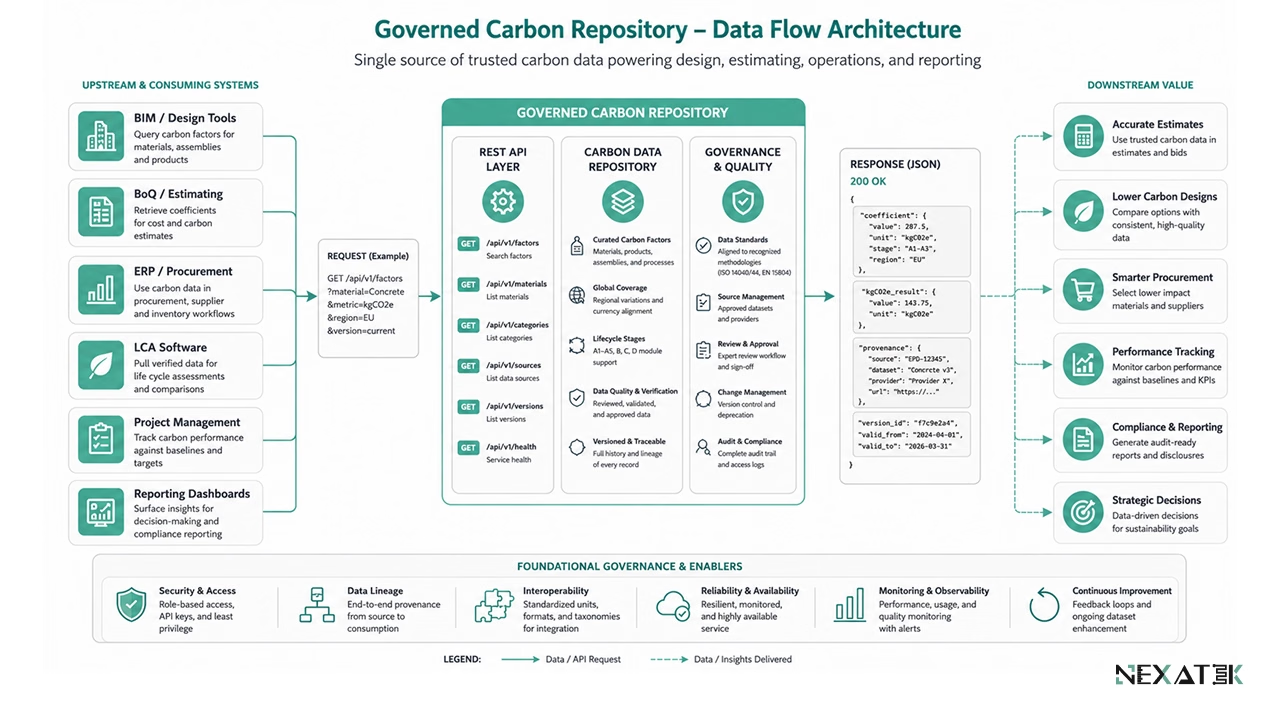 API-Schnittstellen ermöglichen BIM-, AVA-, ERP-, LCA- und Reportingsystemen den Zugriff auf dieselbe validierte Datenquelle.
Die Synchronisationslogik löst das Problem dynamischer Datenbestände: Strommixfaktoren ändern sich turnusmäßig, und EPD-Bibliotheken wachsen kontinuierlich. Zeitgesteuerte Hintergrundprozesse importieren aktualisierte Werte und benachrichtigen angebundene Systeme, falls ein in laufenden Projekten verwendeter Faktor abgelöst wurde.
Zugriffskontrollen und Revisionssicherheit vervollständigen das Anforderungsprofil: Jedes anfragende System authentifiziert sich über eigene Zugriffsschlüssel. Jeder gelieferte Ausgabewert enthält die ID der jeweiligen Berechnungsversion. Definierte Abruflimite (Rate Limits) sorgen für planbare Systemlasten bei umfangreichen Massenabfragen.
Dieselben Schnittstellen ermöglichen die automatisierte Anbindung von LCA-Daten an ERP- und Projektsteuerungssoftware. CO2-Kennzahlen erscheinen dadurch innerhalb integrierter Unternehmenssysteme direkt neben Kosten- und Termindaten.
Automatisches Datenmapping und Validierung von Faktoren
Neue Datensätze werden vor der Aufnahme systematisch geprüft: Einheitenprüfungen weisen Faktoren ab, die pro Quadratmeter deklariert sind, wenn die Materiallogik Kubikmeter verlangt. Plausibilitätsprüfungen vergleichen jeden neuen Wert mit hinterlegten Referenzdaten und halten Einträge, die beispielsweise um mehr als 40 % abweichen, zur manuellen Prüfung an. Datensätze ohne anerkanntes Verifizierungsprogramm oder ohne Gültigkeitsdatum werden an der Schnittstelle blockiert.
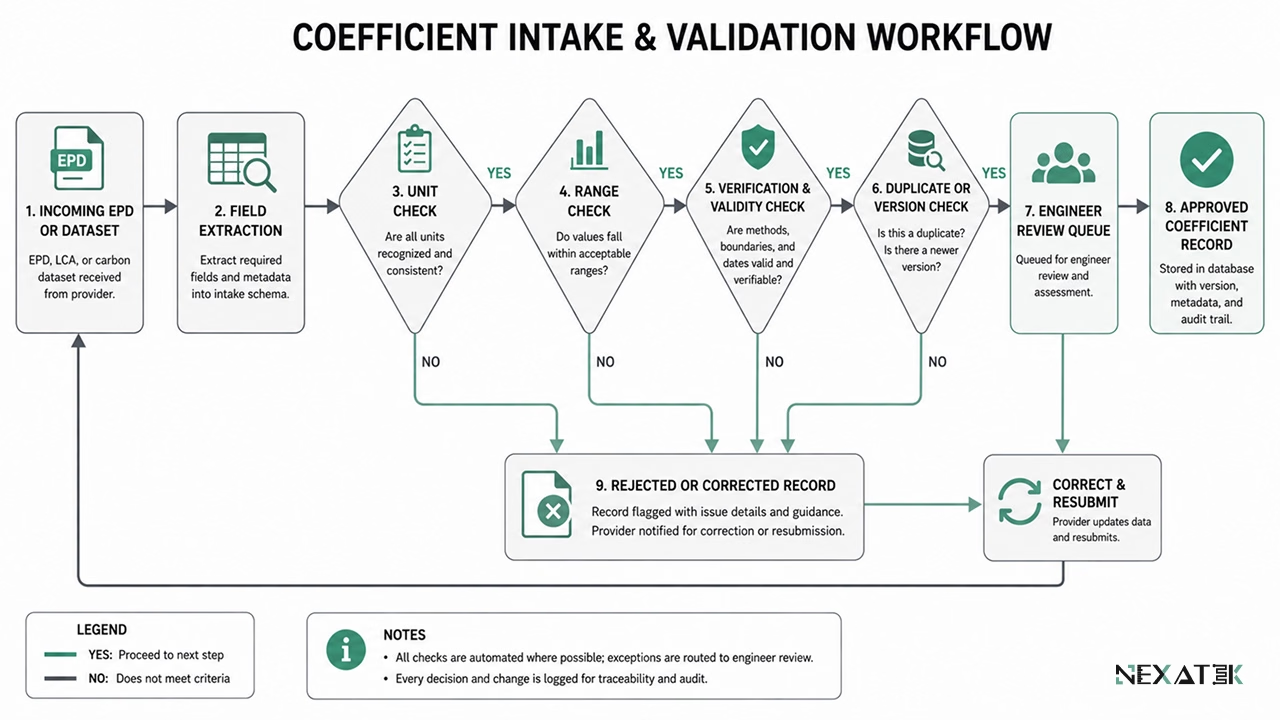 Validierungsroutinen verhindern fehlerhafte Einheiten, fehlende Nachweise, abgelaufene Daten und unplausible Werte in Berichten.
Diese Prüfungen verhindern elementare Fehlerquellen: Ein Faktor, der versehentlich mit 185 kgCO2e statt mit 1,85 kgCO2e eingegeben wird, scheitert unmittelbar an der Schwellenwertprüfung, bevor er in Projektauswertungen einfließen kann.
Die automatisierte Datenerfassung übernimmt das Einlesen von Deklarationen: Mittels strukturierter Feldextraktion wird eine publizierte EPD in einen sauberen Datensatz überführt. Eine Exception-Queue leitet unvollständige Dokumente an menschliche Prüfer weiter, statt sie ungeprüft zu übernehmen. Derartige Workflows stellen praxiserprobte Prozessautomatisierung im Ingenieurbau für Klimadaten dar.
Regulatorische Compliance und Branchenstandards (PAS 2080 & RICS)
Regelwerke zur Dekarbonisierung von Infrastrukturen fordern belastbare Nachweise statt pauschaler Behauptungen. PAS 2080, der globale Standard für das Treibhausgasmanagement in der Infrastruktur, verlangt das Aufstellen von Baselines und die Quantifizierung von Emissionen über die gesamte Wertschöpfungskette hinweg. Der RICS-Leitfaden für Whole Life Carbon definiert hierfür einheitliche Modulgrenzen. Beide Standards setzen Daten voraus, deren Herkunft lückenlos belegbar ist.
Die relationale Datenbankstruktur liefert diese Nachvollziehbarkeit automatisch: Jede Zahl in einem CO2-Bericht verweist auf einen konkreten Faktor samt dokumentierter Gültigkeit. Fragt ein Auditor, warum für eine Stahlposition im Jahr 2025 ein spezifischer Wert angesetzt wurde, genügt eine Datenbankabfrage anstelle einer zeitraubenden Suche in Projektverzeichnissen. Eine einheitliche Modulzuordnung gewährleistet zudem die Vergleichbarkeit über gesamte Infrastrukturportfolios hinweg.
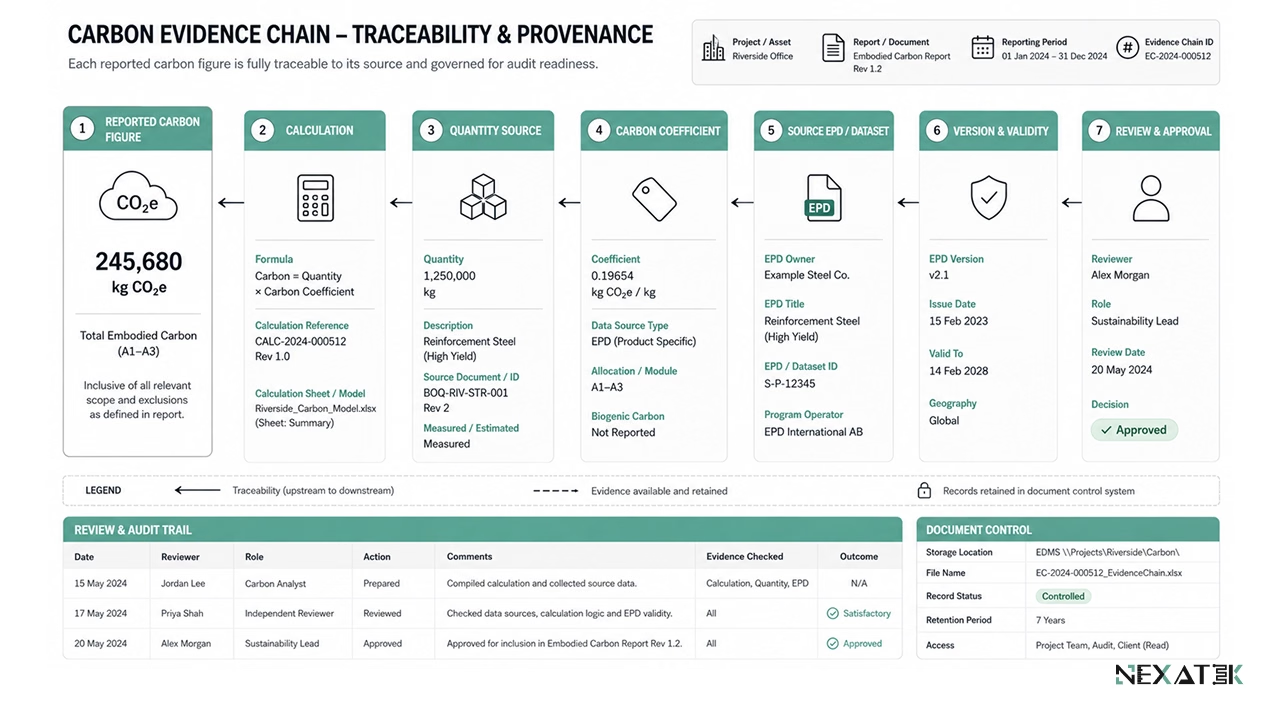 Lückenlose Nachvollziehbarkeit verknüpft Kennzahlen mit Faktoren, Quelldokumenten, Versionen und Gültigkeitsdaten.
Im Vergabeprozess beweist die Standardisierung ihren wirtschaftlichen Nutzen: Wenn zwei Bieter die Emissionen derselben Betongüte anhand identischer Kennwerte deklarieren, wird der ökologische Vergleich belastbar. Der Auftraggeber kann die CO2-Intensität gleichberechtigt neben den Angebotspreis stellen.
Semantisches Mapping: Die Brücke zwischen Leistungsverzeichnis und CO2-Faktor
Ein Leistungsverzeichnis (LV) beschreibt Materialien in der projektspezifischen Sprache des Ausschreibenden: „Beton C32/40, sulfatbeständig, für Pfahlkopfplatten“. Ein CO2-Datensatz beschreibt dasselbe Material mit abweichender Nomenklatur, wobei Festigkeitsklasse und Zementart oft anders codiert sind. An dieser Schnittstelle verlieren manuelle Berechnungen den Großteil ihrer Präzision.
Semantisches Mapping automatisiert diesen Zuordnungsschritt: Die Parsing-Logik zerlegt jede LV-Position in strukturierte Materialattribute und schlägt den am besten passenden Faktor aus dem Materialkatalog inklusive eines Konfidenzwerts vor. Festigkeitsklasse und Zementtyp werden als eigenständige Parameter behandelt, sodass auch unvollständige Beschreibungen treffsicher eingegrenzt werden.
Eine Position wie „Bewehrungsstahl B500B, d = 16 mm“ wird direkt mit dem entsprechenden EPD-Eintrag für Betonstahl verknüpft. Eine uneindeutige Ausschreibungsposition wie „Bodenaustauschmaterial, geliefert“ wird zur Klärung an einen Prüfingenieur übergeben.
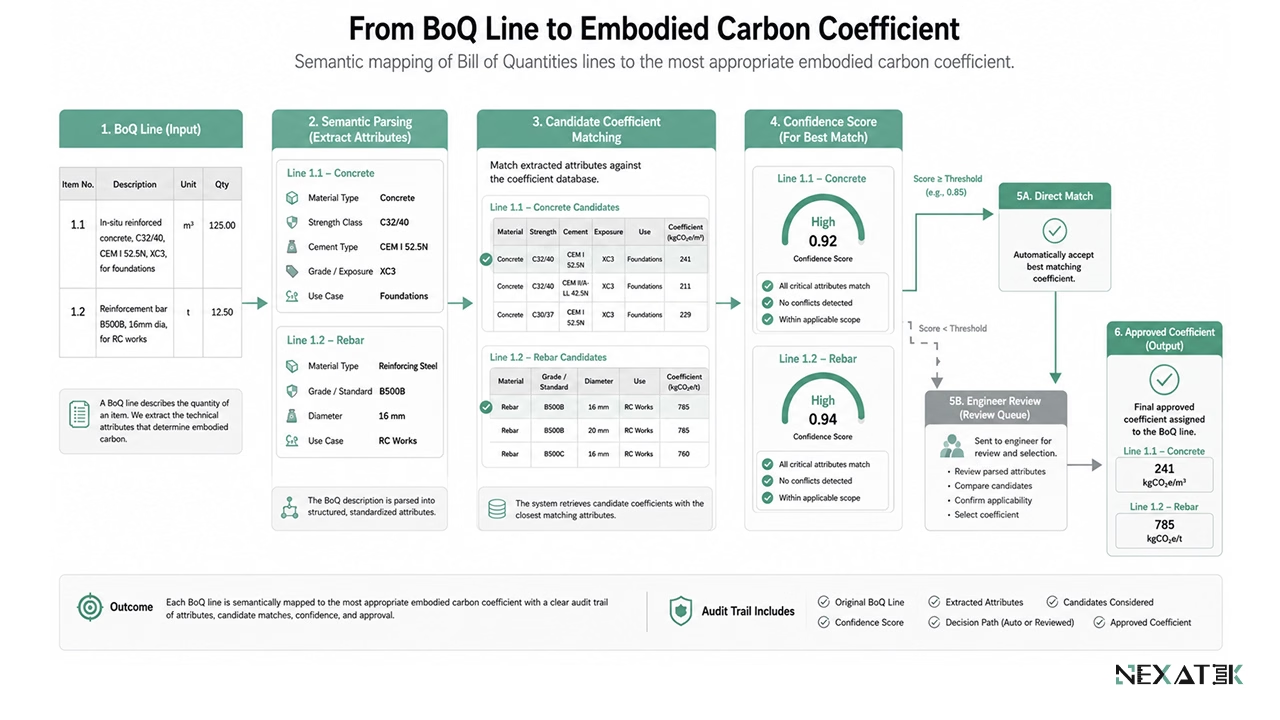 Semantisches Matching wandelt Ausschreibungstexte in Attribute um, bevor der am besten passende Faktor vorgeschlagen wird.
Fehlzuordnungen – wie etwa die Zuweisung eines Standardbetonfaktors für eine emissionsarme Spezialmischung – verfälschen jede darauf aufbauende Auswertung. Ein KI-gestütztes Matching mit ingenieurtechnischer Freigabe dokumentiert die Begründung jeder Zuordnungsentscheidung.
Die Zuordnungsregeln lernen mit jedem Arbeitsschritt: Bestätigte Treffer fließen in das System zurück, und wiederkehrende Textbausteine aus AVA-Programmen werden zu deterministischen Regeln. NEXATEK verfeinert diese Zuordnungsmethoden kontinuierlich im Rahmen angewandter Ingenieurforschung, sodass die Systementscheidungen transparent, dokumentiert und prüfbar bleiben.